La IA en la Olimpiada de Matemáticas: de la plata al 42
Nivel bachillerato7 min de lecturaPor Fernando Hernando
Del AlphaGeometry de 2024 al oro de 2025 y los anuncios de 2026: qué ha logrado la IA en la Olimpiada Matemática Internacional y qué matices conviene conocer.
cada dato lleva su fuente al final
Seis problemas, nueve horas repartidas en dos mañanas y ninguna fórmula que baste por sí sola. Cada problema vale siete puntos y el máximo es 42. Ese es el formato de la Olimpiada Internacional de Matemáticas (IMO), que se celebra desde 1959, cuando la primera edición tuvo lugar en Rumanía, y a la que acuden estudiantes de menos de 20 años de más de cien países. Durante décadas fue territorio humano. En 2024 una máquina se quedó a un punto del oro. En 2025 lo alcanzó. En 2026 hay empresas que dicen haber llegado al 42. Hay hazaña y letra pequeña.
Primero, solo geometría
El primer aviso serio llegó en enero de 2024. Un equipo de DeepMind publicó en Nature (el anuncio es del 17 de enero) un sistema llamado AlphaGeometry. Aprendió sin ver una sola demostración humana: generó unos cien millones de ejemplos sintéticos, partiendo de figuras al azar y deduciendo todo lo deducible, y con eso entrenó un modelo de lenguaje.
¿Para qué un modelo de lenguaje en geometría? Para lo único que un motor de reglas no sabe hacer solo: inventar. Queremos probar que en un triángulo isósceles con los ángulos de la base son iguales, . Con los datos que tenemos no salta a la vista ningún par de triángulos que comparar (hay un truco clásico, atribuido a Pappus, que compara el triángulo consigo mismo, pero no es la vía habitual). Una demostración natural arranca cuando alguien añade un punto , el punto medio de , y traza . Entonces los triángulos y tienen
los tres lados iguales, luego son congruentes y los ángulos en y en coinciden.
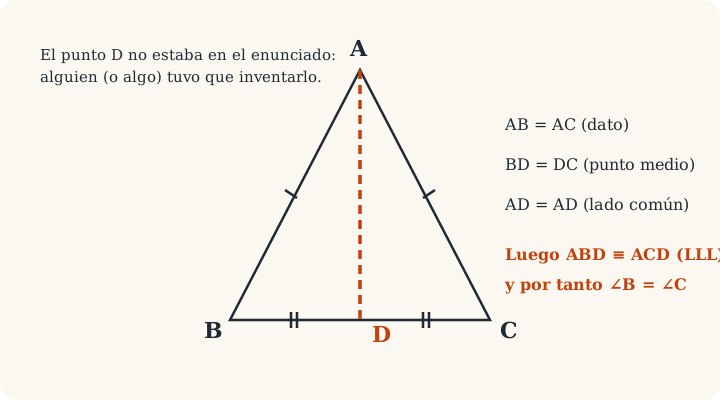
El motor simbólico aplica reglas con paciencia infinita y calcula todas las consecuencias de la figura. Cuando se atasca, el modelo propone una construcción auxiliar (un punto, una paralela, un círculo) y el motor vuelve a deducir. El resultado es una demostración legible paso a paso.
Los números: 25 de 30 problemas de geometría de olimpiada resueltos, frente a 10 del mejor método anterior. Un medallista de oro humano resuelve de media 25,9 de esos mismos 30. Pero no era un examen en condiciones reales: eran 30 problemas de geometría de olimpiadas entre 2000 y 2022, y la geometría es solo una parte de una IMO. Aun así, el salto de 10 a 25 era enorme. Un artículo de febrero de 2025 describe a su sucesor, AlphaGeometry 2, que llega al 84 % de los problemas de geometría de los últimos 25 años de la IMO, frente al 54 % de la versión original.
2024: la plata, por un punto
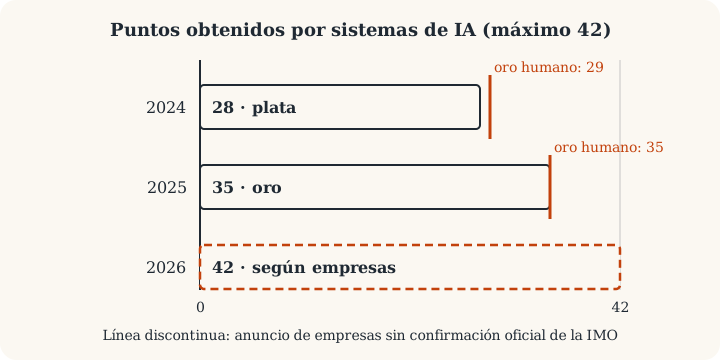
En julio de 2024, durante la IMO, DeepMind anunció que AlphaProof y AlphaGeometry 2 habían resuelto cuatro de los seis problemas. Cuatro por siete son 28 puntos de 42. El corte de oro fue 29. La máquina estaba, por primera vez, a nivel de medalla, y de plata. Nadie compitió con nadie.
El reparto fue este. AlphaProof resolvió dos problemas de álgebra y uno de teoría de números; entre ellos estaba el más difícil de la prueba, que solo cinco concursantes humanos lograron resolver. AlphaGeometry 2 despachó el de geometría en 19 segundos. Los dos de combinatoria quedaron sin resolver.
AlphaProof trabaja de otra manera. No escribe prosa matemática, sino pruebas en Lean, un lenguaje formal en el que cada paso lo comprueba el ordenador, de modo que un resultado aceptado es correcto, siempre que el enunciado formal diga lo mismo que el original. Lo entrena con aprendizaje por refuerzo al estilo de AlphaZero y, según el artículo de Nature de 2025, partió de millones de enunciados traducidos automáticamente a lenguaje formal. El truco tiene un precio: alguien tuvo que traducir a mano los problemas de la IMO a Lean antes de dárselos, y el sistema resolvió un problema en minutos y tardó hasta tres días en los demás, mientras que un estudiante dispone de 4,5 horas por sesión. Las soluciones las corrigieron Timothy Gowers y Joseph Myers con los criterios de la IMO. Por eso la «plata» lleva asterisco.
2025: el oro, con dos asteriscos distintos
Un año después el panorama cambió de naturaleza. En la IMO de 2025, en Sunshine Coast (Australia), con pruebas el 15 y el 16 de julio, los cortes fueron 35 para el oro, 28 para la plata y 19 para el bronce. Dos laboratorios anunciaron 35 puntos, cinco problemas de seis, y esta vez con modelos que leían los enunciados en lenguaje natural y escribían las soluciones en prosa, sin pasar por Lean.
Google DeepMind comunicó el 21 de julio que una versión avanzada de Gemini con Deep Think había resuelto cinco problemas dentro del tiempo reglamentario, y que sus soluciones habían sido corregidas y certificadas por coordinadores de la propia IMO con los mismos criterios que las humanas. El presidente de la organización, Gregor Dolinar, lo confirmó con estas palabras, que recoge el blog de DeepMind: “We can confirm that Google DeepMind has reached the much-desired milestone”. La IMO precisó que certificó las soluciones, no el sistema ni el modelo.
OpenAI se había adelantado el 19 de julio. Según el mensaje de su investigador Alexander Wei, tal y como lo recoge Simon Willison, un modelo experimental de razonamiento, sin herramientas y con dos sesiones de 4,5 horas, obtuvo también 35 puntos, y las soluciones fueron corregidas por tres antiguos medallistas de la IMO que alcanzaron consenso unánime. La corrección no la hizo la organización. De ahí que las dos medallas no sean equivalentes: la de DeepMind pasó por la corrección oficial; la de OpenAI, por una externa. Según The Neuron, hubo además una polémica de plazos: la IMO habría pedido que no se hablara de la IA hasta una semana después de la clausura, y Mikhail Samin acusó a OpenAI de romper ese acuerdo (es una acusación suya, no un hecho confirmado por la IMO).
Terence Tao, según The Neuron, advirtió de que, sin una metodología controlada y no elegida por los propios equipos, comparar a una IA con los estudiantes es frágil: cuentan el tiempo, las herramientas, el trabajo en equipo y el número de intentos. Un preprint de julio de 2025, sin revisión por pares y aplicado a problemas ya publicados, mostró que una canalización de verificación y refinamiento con modelos comerciales resolvía cinco de los seis, frente al 21,4 %-38,1 % por problema de esos modelos por sí solos; según los autores, el bucle de verificación explica la mejora.
2026: el 42, según quien lo cuenta
La IMO de 2026, la 67.ª, se celebró en Shanghái y se clausuró el 20 de julio. En las noticias de su web oficial que he revisado no aparece ningún comunicado sobre resultados de IA; lo que sí cuenta es que OpenAI, patrocinador de la asociación de la IMO, ofrecía doce meses de ChatGPT Pro a los medallistas de oro y a las ganadoras del premio Mirzakhani. Los resultados llegaron por otra vía. Según la agencia AFP, Huawei y Xiaohongshu (RedNote) anunciaron puntuaciones perfectas (el 100 %, es decir, 42 sobre 42) con sus modelos. Según AFP, las empresas recibieron los problemas una vez terminada la prueba humana y con un límite de tiempo. Xiaohongshu afirma que entregó las soluciones a los organizadores y que ningún modelo de lenguaje había logrado antes una puntuación perfecta en la corrección oficial. Son afirmaciones de las empresas, sin confirmación oficial de la IMO que yo haya encontrado. De Huawei, AFP no da detalles sobre la corrección. AFP recoge también una prueba informal de Deedy Das, de Menlo Ventures, que habría obtenido 42 con cuatro modelos, entre ellos los de OpenAI y Anthropic; no es corrección oficial.
Lo que sí cambia y lo que no
¿Lenguaje formal o natural? ¿Tiempo humano o tres días? ¿Corrección oficial o externa? Los 28 puntos de 2024 y los 35 de 2025 no se miden con la misma regla, aunque se parezcan.
Y, sin embargo, la tendencia es nítida: en dos años se pasó de resolver problemas de geometría a puntuar al nivel del oro en una IMO entera, con soluciones en prosa. Lo que sigue abierto es lo más interesante: un problema de la IMO está diseñado para tener una solución elegante, y los de investigación llevan años sin que nadie sepa si la tienen. Quizá asistentes de pruebas como Lean sean el puente: una máquina cuyas pruebas pasan la comprobación formal es una colega a la que se puede escuchar.
La lección práctica es antigua. Sistemas como AlphaGeometry, con sus millones de ejemplos, empiezan como el triángulo isósceles de arriba: mirando la figura y preguntándose qué punto falta. Esa pregunta sigue siendo tuya también.
Fuentes
- Google DeepMind (2024). AlphaGeometry: An Olympiad-level AI system for geometry.
- arXiv:2502.03544 (2025). Gold-medalist Performance in Solving Olympiad Geometry with AlphaGeometry2.
- Google DeepMind (2024). AI solves IMO problems at silver-medal level.
- Hubert, Mehta, Sartran et al. (2025). Olympiad-Level Formal Mathematical Reasoning with Reinforcement Learning. Nature (DOI 10.1038/s41586-025-09833-y), ficha en Google Research.
- UKMT (2025). IMO 2025 results.
- Google DeepMind (2025). Advanced version of Gemini with Deep Think officially achieves gold-medal standard at the International Mathematical Olympiad.
- Simon Willison (2025). OpenAI’s gold medal performance on the International Math Olympiad. Simon Willison’s Weblog.
- The Neuron (2025). OpenAI OR Google (or both) just achieved Gold in the International Math Olympiad… but who?.
- Wikipedia. International Mathematical Olympiad.
- arXiv:2507.15855 (2025). Winning Gold at IMO 2025 with a Model-Agnostic Verification-and-Refinement Pipeline.
- IMO (2026). IMO 2026 Concludes in Shanghai. Sitio oficial.
- IMO (2026). OpenAI ofrece ChatGPT Pro a los medallistas de oro de la IMO 2026. Sitio oficial.
- AFP (2026). AI catches up with humans to score 100pc at top maths contest. Taipei Times.
Publicado el